Neu

OnTopic KI Workflow/Progress

  • Ersteller Ersteller K4c38v5kdz7rv-332
  • Erstellt am Erstellt am
Bitte genau im Thema bleiben (wie es im ersten Beitrag steht). Bei neuen oder anderen Themen bitte einen eigenen Thread aufmachen!
K

K4c38v5kdz7rv-332

Guest
Hallo KI-Nutzer,

Disclamer:
der Thread hier richtet sich außschließlich an Leute die mit KI arbeiten. HIer soll es nicht um phillosofische Fragen gehen. Wer mit KI nichts anfangen kann, mich, das Thema und KI generell blöd findet, der postet bitte hier auch nichts. Ich werde jeden melden der sich nicht an die Regeln hält, Stänkerheinis ohne Argumentationswillen müssen draußen warten!

Thema:
Hier soll es um den Austausch darüber gehen wie ihr KI nutzt, also erstellt ihr ein Konzept, lasst ihr euch, wie ich, Markdown Dateien erzeugen, mit Konzept, Spezifikationen und Richtlinien oder promptet ihr einfach drauf los. Welche Modelle nutzt ihr wie, Abo, lokal? All sone Dinge würde ich gern hier sammeln.

EDIT: Hier könnt ihr auch euren KI-Progress posten!

Aber es soll auch über die Workflows diskutiert werden.

Als Einstieg hier mal ein Video, welches ich gerade gesehen habe und was mir verdeutlicht wie schnell die Entwicklung da gerade ist. Was vor 3 Monaten noch gut war, kann heute schon wieder eher kontraproduktiv sein.

 
Zuletzt bearbeitet von einem Moderator:
  • Daumen hoch
M.i.a.u.: oli
Ich würde vorab die Frage klären, ob wir diese Art von Themen überhaupt in einem Bereich diskutieren wollen,
in dem, würde ich mal behaupten, die meisten Menschen eher künstlerisch aktiv sind.

Das, worauf du abzielst, ist eindeutig nicht künstlerisch. Nicht mal ansatzweise.

Es ist, als ob du in einem Forum, in dem es um´s Malen mit der Hand geht, über KI-Bilder sprechen möchtest.

Das ist so themenfern wie Politik.
 
  • Daumen hoch
M.i.a.u.: GDU
Das ist so themenfern wie Politik.
Politik betrifft alle Lebensbereiche. Wird hier nur wenig diskutiert um die Stimmung nicht kippen zu lassen.

Ob Leute „Programmierung“ diskutieren wollen oder nicht, würde ich einfach den Leuten überlassen.

Da man damit auch im Musikkontext interessante Tools erstellen kann , find ich das nicht so deplatziert.
 
  • Daumen hoch
  • Zustimmung
M.i.a.u.: Christoph1972, moogli und TGN
Du bist der Meinung hier im Forum wird mehr über Kunst geredet als über Technik?

Technik ist Teil der Kunst, wenn das Ergebniss keine Kunst ist, hat die Technik dahinter auch keine Relevanz.

Und KI kann keine Kunst sein, dazu bedarf es immer zu einem bedeutenden Anteil menschlichen Zutuns.
 
Meine ersten Gehversuche bestätigen die These im Video.
Am besten konkret sagen was man will, was das Tool können soll.
Weniger technische Details zur Umsetzung vorgeben, es sei den sie sind nicht alltäglich und ganz problemspezifisch.
Z.B. bei meiner Copperlan Translation Teile des SDK oder Mididokumentation.

Man sollte allerdings ausgiebig prüfen was da so programmiert wird, da stecken immer wieder Fehler im Detail oder manche Dinge sind von der Bedienung her unlogisch.

Außerdem wird das Ganze recht schnell, recht teuer. Es lohnt sich also recht gut zu wissen was man will und zielstrebig darauf hinzuarbeiten.

Ein Problem wird im Video aber, eher beiläufig genannt: beim erstellen von Videos oder Bildern sei es auch besser nicht zu genau vorzuschreiben was man will... die eigenen Ergebnisse der KI seien besser.
Wer das nicht hochproblematisch findet... da weiß ich auch nicht.
 
  • hilfreich
M.i.a.u.: K4c38v5kdz7rv-332
Das würde ich bezogen auf das Forum nicht allgemeingültig stehen lassen. Mein Eindruck ist das bei einem gehörigen Anteil einfach die Technik der Zweck ist.

Es gibt Techniker, Musiker und die dazwischen. Verwerflich? Nö, aber darum geht´s ja nicht.
 
Doch es geht hier darum, dass endlich jeder der gern Musik macht und an Technik interessiert ist sich seine eigenen Instrumente bauen kann. Das Vorzugsweise in From von Software aber ich vermute mal auch für den Lochrasteraufbau kann dir KI was beisteuern, auch dort würde mich ein KI-Workflow interessieren. Ich könnte mir vorstellen dass die KI Schaltpläne entwickelt und die in SPLICE oder ähnlichem testet und man die WAV anhört und beurteilt, wenn alles passt werden dann Dateien erzeugt die man zu PCBWay oder Konsorten schickt und dann baut man das zusammen. Wie gesagt, den Weg habe ich noch nicht ausprobiert, wird sicher nächstes Jahr aber mal gemacht, dann könnte man sogar Hardware mit KI Hilfe entwickeln.

Bei FPGA Geschichten sehe ich auch hohes Potenzial dass man da mit KI eine Menge machen kann, ohne tiefe Kenntnisse haben zu müssen.
 
Zuletzt bearbeitet von einem Moderator:
  • Daumen hoch
M.i.a.u.: oli und DrMickey
ganz kurz gesagt:

lasst ihr euch, wie ich, Markdown Dateien erzeugen, mit Konzept, Spezifikationen und Richtlinien
ja, allerdings beruflich - privat habe ich bisher keine komplexere Software erstellen lassen, nur kurze Scripte.

Welche Modelle nutzt ihr wie, Abo, lokal?
in der Firma haben wir Zugriff auf die Frontier-Modelle von Anthropic, Google und OpenAI, mehr oder weniger ohne Creditlimits. Dazu gibt es noch ein paar kleinere lokale Modelle.

Privat verwende ich hauptsächlich GPT im Plus-Abo.

Weniger technische Details zur Umsetzung vorgeben, es sei den sie sind nicht alltäglich und ganz problemspezifisch.
ja, das braucht etwas erfahrung, wie detailliert man für den jeweiligen Zweck Dinge vorgeben muss, um das beste Ergebnis zu erhalten.

Außerdem wird das Ganze recht schnell, recht teuer. Es lohnt sich also recht gut zu wissen was man will und zielstrebig darauf hinzuarbeiten.
Auch das ist richtig.
 
  • hilfreich
M.i.a.u.: K4c38v5kdz7rv-332
  • #10
ja, das braucht etwas erfahrung, wie detailliert man für den jeweiligen Zweck Dinge vorgeben muss, um das beste Ergebnis zu erhalten.
Das scheint sich ja echt alle paar Monate zu ändern, wie im Paper im Video zu sehen scheinen dann so einige Markdown Dateien eher hinderlich zu sein. Ich werde daher mal bei dem nächsten Projekt komplett darauf verzichten, mal schauen!
 
  • #11
das unterscheidet sich auch von Model zu Model ... und kommt natürlich auch auf den jeweiligen Harness bzw. die Guardrails an, die du als User nicht unbedingt siehst (z.B. bei Github Copilot gibt es unterschiedliche Harnesses, die aber eine starke Wirkung auf den Stil bzw. das Responseverhalten des LLM haben).
 
  • #12
Technik ist Teil der Kunst, wenn das Ergebniss keine Kunst ist, hat die Technik dahinter auch keine Relevanz.

Und KI kann keine Kunst sein, dazu bedarf es immer zu einem bedeutenden Anteil menschlichen Zutuns.
Wenn ein Künstler Hammer und Meißel nimmt um eine Statue zu erzeugen können die auch aus 'nem Baumarkt stammen ;-) Selbst wenn man von einer künstlerischen Intention ausgeht und es sich nicht einfach nur um Gebrauchs-/Verbrauchsmusik handelt, darf das Werkzeug imho auch mit K.I. Hilfe erstellt worden sein.
 
  • #13
Hit and Miss.
Gestern hat Astra mit einem absolut trivialen Patch, der mit zig Tests abgesichert war den MG Server eine Stunde flach gelegt.
Habe auch schon mehrmals gesehen: Test ist rot -> Lösung der KI: fixe den Test
Habe viel mit legacy Code zu tun, da gibt es die meisten Probleme.

Auf der anderen Seite sind die Ergebnisse erstaunlich: letzte Woche habe ich eine Sample Bank Creator App für die Rossum SP-1200 gevibecoded ohne eine Zeile selbst zu programmieren. Die KI hat die Binary Firmware analysiert und herausgefunden wie Start, End und Looppunkte geschrieben werden müssen und dann noch ein UI drauf gesetzt. Die Rossum Firmware ist allerdings auch nur 22kb groß.
 
  • hilfreich
M.i.a.u.: K4c38v5kdz7rv-332
  • #14
Hit and Miss.
Gestern hat Astra mit einem absolut trivialen Patch, der mit zig Tests abgesichert war den MG Server eine Stunde flach gelegt.
Habe auch schon mehrmals gesehen: Test ist rot -> Lösung der KI: fixe den Test
Habe viel mit legacy Code zu tun, da gibt es die meisten Probleme.

Auf der anderen Seite sind die Ergebnisse erstaunlich: letzte Woche habe ich eine Sample Bank Creator App für die Rossum SP-1200 gevibecoded ohne eine Zeile selbst zu programmieren. Die KI hat die Binary Firmware analysiert und herausgefunden wie Start, End und Looppunkte geschrieben werden müssen und dann noch ein UI drauf gesetzt. Die Rossum Firmware ist allerdings auch nur 22kb groß.

Verwendest du Astra im Ultra Mode? Und ich hatte das Glück Fable 5.5 zu testen und ich kann euch sagen…es ist unglaublich, jetzt ist schon alles unglaublich.
 
  • Daumen hoch
  • hilfreich
M.i.a.u.: oli und K4c38v5kdz7rv-332
  • #15
Mod-Hinweis: OT- und Metadiskussion abgetrennt, da es sich um einen "On Topic"-Thread handelt.
 
  • Daumen hoch
  • wunderbar
M.i.a.u.: oli und K4c38v5kdz7rv-332
  • #16
Danke für Aufwischen hier!
Auch danke an die Menschen, die hier ernsthaft ihre Erfahrungen teilen!

@Martin Kraken Wie bist du denn an Fable5.5 gekommen, falls du das sagen darfst?
 
  • #18
Habt ihr auch das Gefühl weniger Iterationen zu brauchen bis ihr am Ziel seid, als noch vor ca 2 Monaten, also vor Opus5.5, Fable5.1 oder Astra?
 
  • #19
Habt ihr auch das Gefühl weniger Iterationen zu brauchen bis ihr am Ziel seid, als noch vor ca 2 Monaten, also vor Opus5.5, Fable5.1 oder Astra?
ich hab keinen Vergleich.. aber ChatGPT 6.1 im Mittel Modus ist schon sensationell.

Übrigens find ich die Verständlichkeit technischer Analysen bei Mistral Vibe echt gut (chatGpt returned da manchmal nur Kauderwelsch)... leider fehlt dem noch vernünftige Desktop integration um sinnvoll tools zu programmieren (der einzige weg wäre ein sync über google drive)
Auch das erstellen z.B. eines Webeditors für einen Syn oder Effektgerät war unfassbar einfach. Alles in einem Rutsch erledigt.
Mistral beobachte ich weiter.
 
  • hilfreich
M.i.a.u.: K4c38v5kdz7rv-332
  • #20
Ja nice, meine große Hoffnung ist ja das man auf dem Level der aktuellen Topmodelle sein lokales Modell betreiben kann. Ohne massig Speicher wird das aber nicht gehen, weswegen der Anschaffungspreis derzeit noch jegeliche Abogebühren in den Schatten stellt. Da warte ich noch 2 Jahre und hoffe, dass sich dann die Speicherpreise wieder etwas einpendeln, unter 64 besser 128GB GPU oder Unified RAM braucht man glaube ich nicht gehen, um auf dem Level von Astra und Co zu arbeiten, mit großem Kontextfenster, also 1M aufwärts.
 
  • #21
Den besten Workflow wird man mit der KI erst haben, wenn man sie an sein Hirn anstöpseln kann und sie unsere Gedanken lesen kann.
 
  • Gute Idee
M.i.a.u.: K4c38v5kdz7rv-332
  • #22
Den besten Workflow wird man mit der KI erst haben, wenn man sie an sein Hirn anstöpseln kann und sie unsere Gedanken lesen kann.
Dann brauch ich auch keine DAW mehr sondern nutze das Brain2Music Interface :waaas:
 
  • #23
Da man damit auch im Musikkontext interessante Tools erstellen kann , find ich das nicht so deplatziert.

Nur weil es nicht deplaziert ist muss man es auch nicht alle 3 Tage wieder aufs Neue diskutieren.

Und es ist schlichtweg falsch, dass Vibecoding einfacher und schneller wäre als z.b. synthedit, vsig oder plug-in hosts zu benutzen und dass das deswegen jetzt jeder kann.

Aktuell gibt es genau 0 Produkte, die es auch nur annähernd mit explizit geschriebenen Code aufnehmen könnten - außer Nachahmungen von Dingen, die es schon seit 35 Jahren gibt. Die hätte man dann aber auch genauso gut per Hand abschreiben können.

Es gibt genau 2 Gruppen von Entwicklern, die... sagen wir mal... mehr KI Assistenz benutzen als selbst zu coden. Das sind zum einen die, die das auch ohne KI könnten, und zum anderen die ganz jungen, die es nur mit KI können. Aber das "jeder" das könnte weil jetzt die KI die Software macht ist halt Unsinn. Die KI erstellt nur die Synthax. Den Rest muss man immer noch selbst können.

"Jeder" kann maximal irgendwas damit machen, aber bestimmt nichts Ideales, nichts Performantes, nichts Wettbewerbsfähiges, und schon gar nichts Neuartiges.
 
Zuletzt bearbeitet:
  • #24
Jeder" kann maximal irgendwas damit machen, aber bestimmt nichts Ideales, nichts Performantes, nichts Wettbewerbsfähiges, und schon gar nichts Neuartiges.
Da bin ich komplett anderer Meinung. Ich kann per Hand nicht mit der Performance mithalten, die die KI ausspuckt. Die KI ist einfach zu interdisziplinär, als dass ich da mithalten könnte. Bei DSP kann ich das nicht so beurteilen, da geht die KI nur bis auf SSE-Optimierung runter und schaut, welche Vektorberechnungen man parallelisieren könnte und welche Worker-Threads sich lohnen usw. Beim Versuch, auch mal was für den C64 zu coden, war das Ergebnis für 3D-Vektorgrafik inklusive einer sehr schnellen Line-Drawing-Routine um Welten besser als das, was ich gemacht hatte, und das war noch mit älteren Modellen.

Es mag noch eine Handvoll Entwickler geben, die mit der aktuellen KI mithalten können, ich bin keiner davon.

Man sollte natürlich schon aufpassen, wenn man etwas für die große, weite Welt da draußen produziert, dann sind Code-Reviews nach wie vor das A und O. Aber noch irgendeine Zeile selbst coden? Nee, der Drops ist bei mir privat wie auch beruflich gelutscht.

Ich möchte nicht wissen, wie viele Softwarebuden mittlerweile auch auf KI setzen. Ich glaube nicht, dass Steinberg*, Ableton*, Native Instruments* usw. sich der Technologie verschließen. Anthropic selbst arbeitet zu 80 % mit KI-Coding, Microsoft ist auch dabei. Na, und in Linux wurden auch schon viele menschliche Fehler durch KI aufgedeckt. Ich glaube, nur im Medizin-, Raumfahrt- und Militärbereich kann man davon ausgehen, dass noch viel per Hand passiert, aber da werden bestimmte Funktionen auch mathematisch verifiziert, also es wird sichergestellt, dass die Funktion exakt das tut, was sie soll, mit Beweis.

Ansonsten glaube ich wirklich, dass per Hand nur noch in der Ausbildung gearbeitet wird, so wie früher mit dem Taschenrechner: Wenn man weiß, wie man das per Hand rechnet, kann man auch den Taschenrechner nutzen, vorher nicht.

Aber das ist alles wieder vom Thema weg, eigentlich geht es hier darum, dass man sich über den KI-Workflow unterhält. Aber gut, mal kurz nach rechts und links abzubiegen, finde ich schon normal, solange das nicht wieder in Rumstänkern gegen die KI-Nutzung ausartet.
 
Zuletzt bearbeitet von einem Moderator:
  • #25
Hier mal den Code für den Ladder Filter, also ich würde da nix mehr rausholen können, ein anderer bestimmt:

C++:
// [url=https://www.thomann.de/de/moog_synthesizer.html]Moog[/url]-Ladder als Schaltungsmodell: implizite Trapezregel, je Sample per Newton gelöst.
// Ein Template für zwei Lanetypen:
//   V = double  -> eine Stimme
//   V = Vec     -> vier Stimmen je AVX2-Register
// Beide Instanzen führen je Lane dieselben IEEE-Operationen in derselben Reihenfolge aus
// (kein FMA) und liefern damit bitgleiche Ergebnisse.

#include <algorithm>
#include <array>
#include <cmath>

// tanh als rationale Minimax-Näherung x*P(x^2)/Q(x^2), Grad 13/6 (Koeffizienten aus Eigens
// generic_fast_tanh_float, hier in double ausgewertet), |Fehler| <= 2.2e-7, ungerade, monoton,
// |t| < 1. Estrin statt Horner: kürzere Abhängigkeitskette, denn die Newton-Schleife ist
// latenz-, nicht durchsatzgebunden.
inline constexpr double fastTanhLimit = 7.99881172180175781;

template <class V>
inline V fastTanhClamped(V x) noexcept
{
    constexpr double a1  =  4.89352455891786e-03, a3  =  6.37261928875436e-04,
                     a5  =  1.48572235717979e-05, a7  =  5.12229709037114e-08,
                     a9  = -8.60467152213735e-11, a11 =  2.00018790482477e-13,
                     a13 = -2.76076847742355e-16;
    constexpr double b0  =  4.89352518554385e-03, b2  =  2.26843463243900e-03,
                     b4  =  1.18534705686654e-04, b6  =  1.19825839466702e-06;

    const V x2 = x * x, x4 = x2 * x2, x8 = x4 * x4;
    const V p  = (a1 + a3 * x2) + x4 * (a5 + a7 * x2) + x8 * ((a9 + a11 * x2) + x4 * a13);
    const V q  = (b0 + b2 * x2) + x4 * (b4 + b6 * x2);
    return x * p / q;
}

// Skalare Lane-Primitive; der AVX2-Typ stellt dieselben Funktionen bereit.
inline double laneAbs(double x) noexcept                         { return std::abs(x); }
inline double laneClamp(double x, double lo, double hi) noexcept { return std::clamp(x, lo, hi); }
inline double laneSelect(bool m, double a, double b) noexcept    { return m ? a : b; }
inline bool   laneAny(bool m) noexcept                           { return m; }
inline double laneMax(double change, double x) noexcept          { return std::max(change, x); }
inline bool   laneLess(double a, double b) noexcept              { return a < b; }
inline bool   laneAndNot(bool a, bool b) noexcept                { return a && !b; }

template <class V>
V laneTanh(V x) noexcept
{
    return fastTanhClamped(laneClamp(x, -fastTanhLimit, fastTanhLimit));
}

// Startwert aus der linearen Extrapolation der beiden vorigen Schritte:
// Fehler zweiter statt erster Ordnung in der Schrittweite.
template <class V>
void start(std::array<V, 4>& y, std::array<V, 4>& previous, int count) noexcept
{
    for (int i = 0; i < count; ++i) {
        const V guess = 2 * y[i] - previous[i];
        previous[i]   = y[i];
        y[i]          = guess;
    }
}

// Abbruch bei |dy|^2 < 0.01 * tol: Bei quadratischer Konvergenz liegt der Restfehler danach
// bei C*|dy|^2, weit unter der Schwelle. Der reine Bestätigungsschritt entfällt
// (im Mittel 2 statt 3 Iterationen).
template <class V, class M>
M converged(M active, V change, double tolerance) noexcept
{
    return laneAndNot(active, laneLess(change * change, .01 * tolerance));
}

// Zustandsupdate der Trapezregel; sehr kleine Werte gehen auf null, bevor sie denormal werden.
template <class V>
void integrate(std::array<V, 4>& s, const std::array<V, 4>& y, int count) noexcept
{
    for (int i = 0; i < count; ++i) {
        s[i] = 2 * y[i] - s[i];
        s[i] = laneSelect(laneLess(laneAbs(s[i]), 1e-30), V(0.0), s[i]);
    }
}

// Ladder: dy_i/dt = w * (u_i - tanh(y_i)),  u_0 = tanh(x - k*y_3),  u_i = tanh(y_(i-1)).
// Trapezregel => y = s + g * (u(y) - tanh(y)).
//
// Die Jacobi-Matrix ist bidiagonal plus ein Rückkopplungseintrag (0,3). Statt allgemeiner LU:
// Vorwärtssubstitution mit dy_3 als Unbekannter (dy_i = p_i + q_i * dy_3), danach
// dy_3 = p_3 / (1 - q_3). Exakt, O(n), ohne Pivotsuche. Die Kehrwerte der Diagonale hängen
// nur von y ab und liegen nicht auf der seriellen Kette p_(i-1) -> p_i.
//
// Jede Lane hat eine eigene Konvergenzmaske: konvergierte Lanes frieren ein. Das Ergebnis einer
// Stimme hängt damit nicht davon ab, mit welchen Stimmen sie ein Register teilt.
template <class V, class M>
V ladder(std::array<V, 4>& s, std::array<V, 4>& y, std::array<V, 4>& previous,
         V x, V g, V k, double tolerance, M active) noexcept
{
    start(y, previous, 4);

    for (int iteration = 0; iteration < 8 && laneAny(active); ++iteration) {
        std::array<V, 4> t{}, slope{}, p{}, q{};
        for (int i = 0; i < 4; ++i) {
            t[i]     = laneTanh(y[i]);
            slope[i] = 1 - t[i] * t[i];   // tanh' aus dem bereits berechneten tanh
        }
        const V feedback = laneTanh(x - k * y[3]);

        for (int i = 0; i < 4; ++i) {
            const V drive    = i == 0 ? feedback : t[i - 1];
            const V inverse  = 1 / (1 + g * slope[i]);
            const V residual = (y[i] - s[i] - g * (drive - t[i])) * inverse;
            if (i == 0) {
                p[0] = -residual;
                q[0] = -g * k * (1 - feedback * feedback) * inverse;
            } else {
                const V lower = g * slope[i - 1] * inverse;
                p[i] = lower * p[i - 1] - residual;
                q[i] = lower * q[i - 1];
            }
        }

        const V delta3 = p[3] / (1 - q[3]);
        V change(0.0);
        for (int i = 0; i < 4; ++i) {
            const V delta = p[i] + q[i] * delta3;
            y[i]   = laneSelect(active, y[i] + delta, y[i]);
            change = laneMax(change, laneAbs(delta));
        }
        active = converged(active, change, tolerance);
    }

    integrate(s, y, 4);
    return y[3];
}
Und hier optimiert auf 4 Stimmen je CPU Register:

C++:
// AVX2-Lanetyp: vier Stimmen in einem __m256d.
// Übersetzt mit /arch:AVX2 bzw. -mavx2 -ffp-contract=off, damit der Compiler keine FMAs bildet.
#include <immintrin.h>

struct Vec {
    __m256d v;
    Vec() = default;
    explicit Vec(double a) noexcept  : v(_mm256_set1_pd(a)) {}
    explicit Vec(__m256d a) noexcept : v(a) {}
};
struct Mask { __m256d m; };

inline Vec operator+(Vec a, Vec b) noexcept { return Vec(_mm256_add_pd(a.v, b.v)); }
inline Vec operator-(Vec a, Vec b) noexcept { return Vec(_mm256_sub_pd(a.v, b.v)); }
inline Vec operator*(Vec a, Vec b) noexcept { return Vec(_mm256_mul_pd(a.v, b.v)); }
inline Vec operator/(Vec a, Vec b) noexcept { return Vec(_mm256_div_pd(a.v, b.v)); }

inline Vec operator+(double a, Vec b) noexcept { return Vec(a) + b; }
inline Vec operator-(double a, Vec b) noexcept { return Vec(a) - b; }
inline Vec operator*(double a, Vec b) noexcept { return Vec(a) * b; }
inline Vec operator/(double a, Vec b) noexcept { return Vec(a) / b; }
inline Vec operator*(Vec a, double b) noexcept { return a * Vec(b); }
inline Vec operator/(Vec a, double b) noexcept { return a / Vec(b); }

inline Vec operator-(Vec a) noexcept { return Vec(_mm256_xor_pd(a.v, _mm256_set1_pd(-0.0))); }

inline Vec laneAbs(Vec a) noexcept { return Vec(_mm256_andnot_pd(_mm256_set1_pd(-0.0), a.v)); }

// Operandenreihenfolge so gewählt, dass NaN sich wie bei std::clamp / std::max verhält
// (MIN/MAXPD liefern bei NaN den zweiten Operanden).
inline Vec laneClamp(Vec x, double lo, double hi) noexcept
{
    return Vec(_mm256_max_pd(_mm256_set1_pd(lo), _mm256_min_pd(_mm256_set1_pd(hi), x.v)));
}
inline Vec laneMax(Vec change, Vec x) noexcept { return Vec(_mm256_max_pd(x.v, change.v)); }

inline Vec  laneSelect(Mask m, Vec a, Vec b) noexcept { return Vec(_mm256_blendv_pd(b.v, a.v, m.m)); }
inline bool laneAny(Mask m) noexcept                  { return _mm256_movemask_pd(m.m) != 0; }
inline Mask laneLess(Vec a, double b) noexcept        { return {_mm256_cmp_pd(a.v, _mm256_set1_pd(b), _CMP_LT_OQ)}; }
inline Mask laneAndNot(Mask a, Mask b) noexcept       { return {_mm256_andnot_pd(b.m, a.m)}; }
Das ist halt das was man rausbekommt ohne das man groß Arbeit rein steckt.
 
  • #27
Aber gut, mal kurz nach rechts und links abzubiegen, finde ich schon normal, solange das nicht wieder in Rumstänkern gegen die KI-Nutzung ausartet.

Ich werde jeden Stänkerheini bei der Kindergartentante melden, der meine Ansicht nicht teilt. Die sind alle blöd...

Ich fürchte du hast zuviel Zeit mit KI verbracht und den Umgang mit Menschen verlernt.
 
  • #28
Solange meine Familie und die Kollegen das nicht sagen, mache ich mir keine Sorgen.

Hier geht es nur darum, dass es OnTopic soweit bleibt, Das KI-Stänkern gibt es in anderen Threads genug, da gibt es sogar eigene für, wie: KI Gefahr für ....
Deswegen lege ich hier als Threadstarter eben die Regel fest dass das hier mal soweit draußen bleibt und damit auch die ganzen unnötigen Floskeln: Warum dieses Thema, du bist blöd(oder was anderes negatives), ich hasse KI usw.

Steht dir ja frei einen eigenen Thread zu erstellen wie schrecklich doch alles auf der Welt ist und die KI wird unser Untergang sind, wie verblöden alle usw. und so fort.
 
  • Daumen hoch
M.i.a.u.: Christoph1972, oli und GDU
  • #29
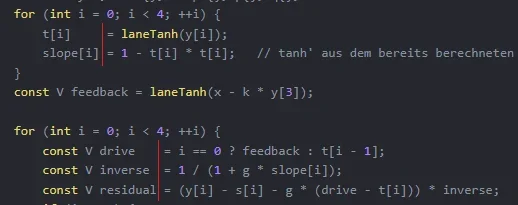
ich freue mich ja, dass außer mir noch jemand das Einrücken von Operatoren bei zusammengehörigen Zeilen goutiert:
1792309458504.webp
 
  • Daumen hoch
M.i.a.u.: stipisic und K4c38v5kdz7rv-332
  • #30
meine aktuelle hardware reicht nicht für ein großes modell.
daher versuche ich mit verschiedenen agenten zur kontrolle, zur entwichlung, zur planung... den enerierten code zu optimieren - gemma 4 war trotz allem unzureichend, jetzt versuche ich es mit qwen 3.8.
wenn die agenten nicht weiter kommen fragen sie codex an.
wenn codex nicht weiterkommt schreibt er mir eine mail und ich muss selbst schauen (was ich kaum kann;)

anstelle von cGPTcodex werde ich bald die api von deepseek testen. langfristig soll alles lokal laufen - dh entweder 2 mal 128 spark oder ein 256mac werden wohl notwendig sein.
 
Zuletzt bearbeitet:
  • Daumen hoch
M.i.a.u.: K4c38v5kdz7rv-332
×
Dir gefällt Sequencer.de? ❤️ Lasse dir unsere neuesten Inhalte in der Google-Suche ganz oben anzeigen!

Zurück
Oben